Normalización de cuotas: de feeds raw a mercados comparables
Cómo identidad de eventos, taxonomía de mercados, formatos, timestamps y reconciliación convierten cuotas raw en datos comparables.
Los datos de cuotas no son un solo número
El precio de una casa de apuestas solamente tiene significado cuando se conoce la identidad completa del mercado. Una cuota americana de -110 no puede compararse con seguridad hasta conocer evento, participante u outcome, tipo de mercado, línea, periodo, lado, sportsbook, timestamp y estado. El mismo número visible puede representar un spread de partido completo, un total de primera mitad o un team total. OffshoreBookmaking trata por ello una cuota como una observación estructurada y no como un valor aislado. Este principio es fundamental para comparadores, historiales de líneas y análisis de trading. Si la identidad que rodea una cuota está incompleta, el software todavía puede mostrar una tabla aparentemente correcta mientras compara proposiciones económicas distintas. La calidad comienza antes de calcular el mejor precio: comienza demostrando que las observaciones pertenecen al mismo mercado canónico.
La identidad del evento es la primera capa de reconciliación
Los proveedores rara vez utilizan el mismo identificador de evento. También pueden formatear de manera distinta equipos, competiciones, horarios e información de sedes neutrales. Un sistema de comparación necesita una identidad interna que sobreviva esas diferencias. El mapeo debería utilizar evidencia estable como deporte, competición, participantes, inicio programado e identificadores del proveedor, con manejo explícito de aplazamientos, dobles jornadas y reprogramaciones. Los nombres por sí solos no bastan porque alias y abreviaturas colisionan. La hora tampoco basta porque los calendarios cambian. Una vez resuelto un evento con confianza, el mapeo entre proveedor y entidad canónica debería persistirse y no volver a adivinarse. Las coincidencias inciertas deben permanecer sin resolver. Los IDs externos conservan procedencia; el objeto canónico pertenece al sistema que reconcilia.
La taxonomía de mercados determina qué puede compararse
Moneyline, spread y total son etiquetas amplias, no identidades completas. Las casas pueden ofrecer partido completo, mitades, cuartos, periodos, innings, team totals, líneas alternativas, props y muchas otras estructuras. Una taxonomía normalizada debería codificar periodo, familia de mercado, alcance del participante y línea cuando corresponda. En béisbol, primer inning y primeros cinco innings no pueden colapsarse en una sola categoría parcial. En hockey, moneyline en tiempo reglamentario y un mercado que incluye overtime pueden tener reglas de settlement distintas. Un comparador debe normalizar semántica, no solamente etiquetas textuales. Cuando aparece un mercado desconocido, un comportamiento fail-closed es más seguro que forzarlo a la categoría conocida más cercana. Puede almacenarse para análisis sin compararlo públicamente hasta resolver su significado.
Línea y precio son dimensiones separadas
Los mercados de spread y total contienen al menos dos valores económicamente importantes: la línea y el precio asociado. Un equipo a -3.5 (-105) no equivale directamente al mismo equipo a -3 (-120). Una oferta puede tener mejor línea pero peor precio, por lo que una interfaz debería evitar reducir ambos conceptos a una sola etiqueta de mejor. Los moneylines normalmente no tienen un handicap separado, pero el precio todavía pertenece a un outcome y periodo específicos. Los registros normalizados deben conservar línea y precio independientemente y mantener los valores originales del proveedor para auditoría. Esta distinción permite interfaces más claras y análisis de movimiento más precisos. También evita que una capa de transformación trate un cambio de handicap como si fuera solamente un cambio de juice.
Los formatos de cuotas representan el mismo precio subyacente
Cuotas americanas, decimales y fraccionales expresan el precio de manera diferente. Un modelo de datos debería evitar almacenar tres verdades independientes que puedan divergir. Debe conservar la representación autoritativa de origen y normalizar a una forma numérica consistente desde la cual puedan derivarse formatos de presentación. Las cuotas decimales son convenientes para muchos cálculos porque representan retorno total por unidad apostada, mientras la probabilidad implícita ofrece otra representación analítica. La conversión requiere cuidado con redondeo. Una cuota americana convertida a decimal y nuevamente a americana puede no reproducir exactamente el valor original si se perdió precisión. Por eso el valor raw debe permanecer junto a campos normalizados. El formato de presentación pertenece a la interfaz; identidad de mercado y valor económico pertenecen a Datos.
Los timestamps revelan etapas diferentes de una observación
Un registro de cuotas puede contener varios tiempos: cuándo el proveedor dice que el precio entró en vigor, cuándo el feed lo observó o publicó, cuándo el operador lo recibió y cuándo la base de datos lo almacenó. Esos timestamps responden preguntas distintas y no deberían colapsarse en un único updated_at. El tiempo efectivo ayuda a reconstruir historia cuando se suministra de forma confiable. El tiempo observado describe el conocimiento del colector. El tiempo registrado ofrece un punto interno de auditoría. Compararlos puede revelar retraso de transporte o backlog de procesamiento. Si el proveedor no suministra tiempo efectivo, el sistema debe preservar ese hecho en lugar de inventarlo. El modelo temporal de OffshoreBookmaking utiliza estados UNKNOWN explícitos porque la falsa precisión es peor que evidencia incompleta. El análisis de movimiento solamente es tan confiable como la semántica temporal que lo sostiene.
La frescura debe medirse a nivel de cada cuota
Una conexión puede estar saludable mientras mercados individuales están obsoletos. El uptime global de una API no demuestra que una cuota mostrada siga vigente. La frescura debería calcularse usando el timestamp disponible más relevante y evaluarse según expectativas para deporte, mercado y estado del juego. Los mercados pregame pueden tolerar un umbral distinto a live betting. Los sistemas pueden marcar observaciones stale, excluirlas de cálculos de mejor precio u ocultarlas según la política del producto. Lo importante es que el estado stale sea determinista y observable. El monitoreo también debe distinguir ausencia de actualización porque el precio realmente no cambió de ausencia porque la ingestión se detuvo. Heartbeats, actividad del evento y comparación entre proveedores aportan evidencia, pero cada señal necesita interpretación documentada en lugar de asumir automáticamente que silencio significa fallo.
Snapshots e historial append-only cumplen propósitos distintos
Un tablero actual necesita la última cuota utilizable, mientras investigación y análisis de movimiento necesitan la secuencia de observaciones que la produjo. Guardar solamente la fila actual destruye historia cada vez que cambia un precio. Guardar todas las observaciones sin estrategia de estado actual puede volver innecesariamente costosas las lecturas públicas. Una arquitectura sólida separa ambos objetivos: agrega observaciones a un historial inmutable o efectivamente append-only y mantiene una proyección actual acotada optimizada para visualización. Las correcciones pueden representarse como nueva evidencia en lugar de reescribir silenciosamente registros antiguos. La proyección puede reconstruirse desde historia si sus reglas son deterministas. Esto conecta directamente con Tecnología y su procesamiento asíncrono y reconciliación. El historial conserva evidencia; la proyección sirve al producto.
El mejor precio debe calcularse entre mercados equivalentes
Encontrar el número más grande de una tabla no basta. Antes de seleccionar un mejor precio, el motor debe asegurar que las cuotas compartan evento canónico, periodo, mercado, outcome y, cuando corresponda, la misma línea. En un spread, un handicap mejor puede importar más que un precio mejor asociado, por lo que la interfaz puede necesitar distinguir mejor línea de mejor precio sobre la misma línea. El algoritmo también debe excluir cuotas stale, suspendidas, inválidas o no disponibles. Elegibilidad del sportsbook y disponibilidad regional pueden ser restricciones adicionales del producto. El cálculo debería exponer suficiente metadata para comprender qué se comparó. Una insignia de mejor precio sin un conjunto de comparación definido genera confianza sin evidencia. La normalización de datos es lo que hace defendible la etiqueta.
El análisis de movimiento necesita una línea base de observación
Un movimiento es la diferencia entre dos observaciones comparables, no simplemente el valor más reciente menos una fila anterior arbitraria. El sistema debe definir la base: cuota de apertura, primera cuota observada, ventana fija u otra referencia explícita. También debe distinguir movimiento de línea y movimiento de precio. Si un spread cambia de -3 a -3.5 mientras el juice cambia en dirección contraria, ambos hechos pueden importar. El análisis entre deportes añade complejidad porque las convenciones varían. Las métricas de movimiento deberían conservar las dos observaciones utilizadas, sus timestamps y fuente para poder reproducir el resultado. Señales derivadas pueden añadirse encima, pero la evidencia subyacente debe permanecer accesible. Así un score analítico no se convierte en reemplazo opaco del historial que resume.
La reconciliación maneja desacuerdos en lugar de ocultarlos
Los proveedores pueden discrepar sobre hora de inicio, estado del evento, disponibilidad de mercado, línea, settlement o incluso identidad de participantes. Una pipeline de normalización no debería sobrescribir automáticamente una fuente con otra solamente porque llegó después. Necesita reglas de autoridad por campo y excepciones explícitas. Algunos hechos pueden tener una fuente preferida; otros requieren confirmación o deben permanecer específicos de una fuente. Los registros de reconciliación deberían conservar valores en conflicto, procedencia y decisión. Esto es especialmente importante en settlement, donde un resultado incorrecto puede afectar dinero. Reglas automáticas pueden resolver casos conocidos, mientras conflictos ambiguos entran a revisión. El objetivo no es eliminar el desacuerdo de los datos, sino hacerlo visible, acotado y resoluble sin corromper historia canónica.
Un modelo práctico para normalizar cuotas deportivas
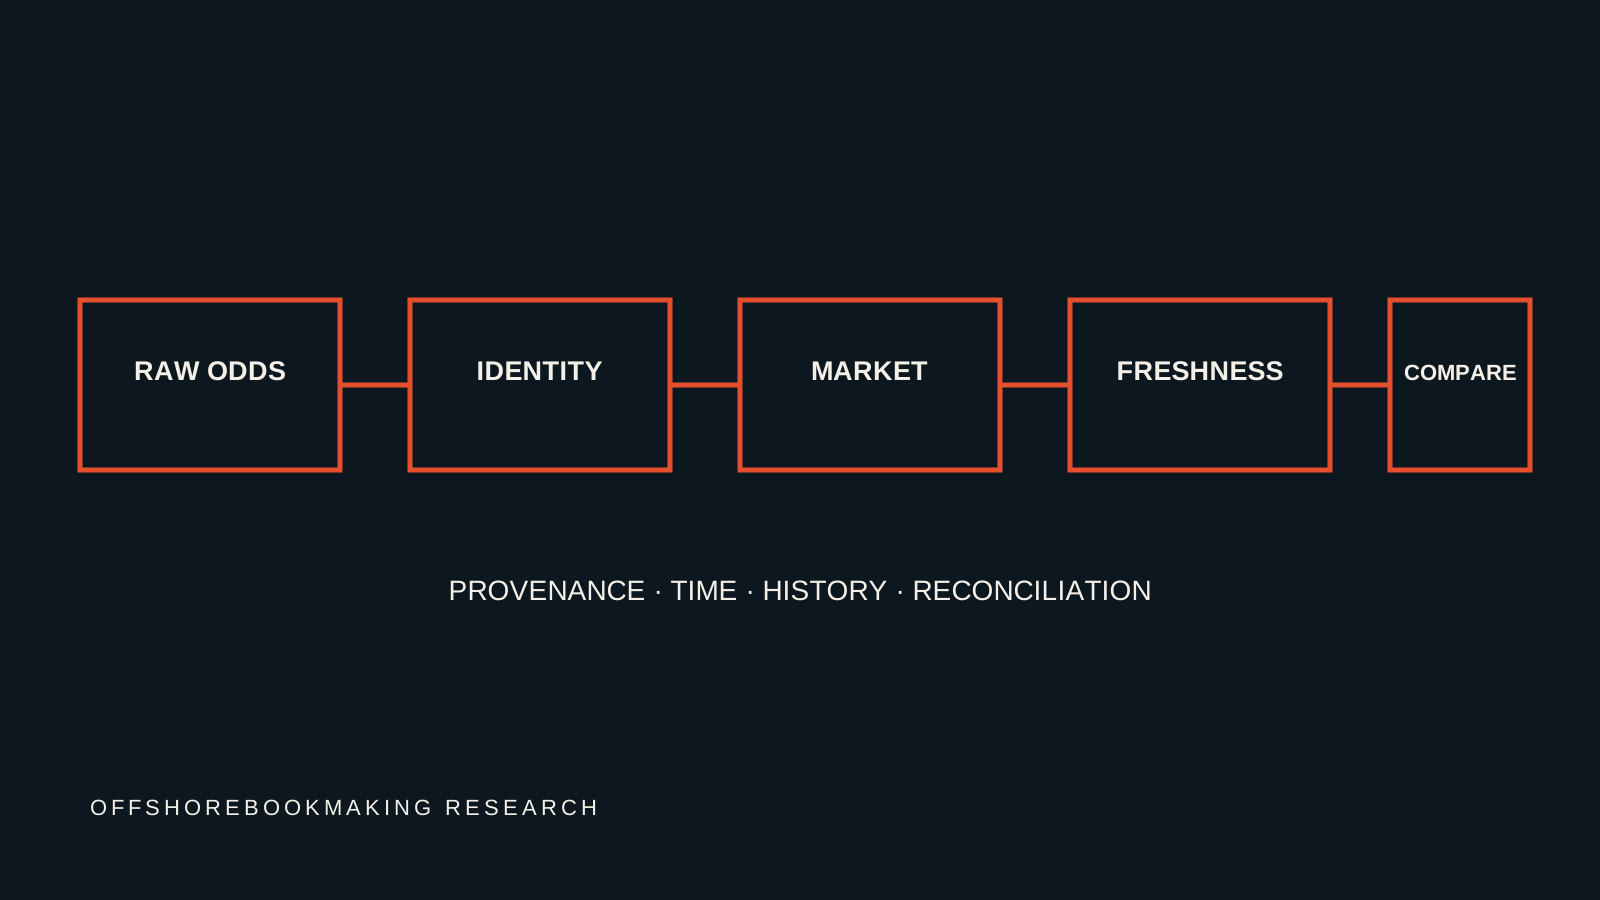
OffshoreBookmaking evaluará pipelines siguiendo la cuota desde la fuente hasta la comparación. Primero se resuelve el evento canónico. Después se identifican periodo, familia de mercado, outcome y línea. Se conservan valores raw y se normaliza el precio a una representación numérica consistente. Se registran procedencia y timestamps distintos. Las reglas de frescura y disponibilidad se aplican antes de que una cuota entre al conjunto actual. Se mantiene historial append-only mientras una proyección acotada sirve lecturas rápidas. Mejor precio o movimiento se calculan solamente entre registros semánticamente equivalentes, conservando la evidencia utilizada por cada métrica derivada. Finalmente, los desacuerdos se reconcilian explícitamente. Este marco conecta Datos con contratos API de Tecnología, manejo de excepciones de Operaciones y evaluación de feeds de Proveedores. Comparar cuotas confiablemente es un problema de identidad, tiempo y evidencia.